같은 계산 블록을 여러 번 쓰면, 모델은 작게 저장하면서 더 깊게 계산할 수 있어요. Looped Transformer 논문을 읽으며 궁금했던 것은 이 가능성이 실제 비용 절감으로도 이어지는가였습니다. 큰 모델을 저장하는 대신 작은 모델을 더 오래 돌리면 저렴해질까요?
저는 모델 크기보다 같은 품질로 요청을 끝내는 비용을 기준으로 보고 싶어요. 가중치를 덜 저장하는 것과 계산을 덜 하는 것은 다르고, GPU가 더 많은 요청을 처리하는 것과 한 사람이 답을 빨리 받는 것도 다르니까요.
공유 메모리를 다룬 LPT 연구에는 이 차이가 선명하게 나타납니다. 전체 처리량은 늘었는데 요청 하나의 계산 지연은 길어졌어요. 이 사례를 이해하기 위해 Transformer가 무엇을 반복하고, 무엇을 기억하는지부터 살펴보겠습니다. (Shared Memory 논문)
이 글은 논문과 공개 구현을 읽은 분석이며, GPU 실험을 독립적으로 재현하지는 않았습니다.
Transformer는 문맥을 참고해 표현을 고쳐요
언어 모델은 문장을 토큰이라는 작은 단위로 나누고, 각 토큰을 숫자들의 묶음으로 바꿔요. 토큰은 단어일 수도, 단어의 일부나 문장부호일 수도 있습니다.
처음의 숫자 표현만으로는 문맥을 충분히 반영하기 어려워요. “은행에 가서 돈을 찾았다”에서 ‘은행’의 의미를 파악하려면 주변 표현을 참고해야 하죠. Attention은 다른 토큰의 정보를 얼마나 참고할지 계산하는 장치입니다. 관련 정보를 모아 현재 토큰의 표현을 바꿔요. 답변을 생성하는 모델은 보통 아직 나오지 않은 미래 토큰은 참고하지 못하도록 제한합니다.
Transformer의 **층(layer)**은 이 Attention과 추가적인 표현 변환을 묶은 계산 단계예요. 문맥을 참고한 뒤 MLP라는 신경망 연산 등으로 표현을 다시 바꿉니다. 실제 층에는 정규화와 이전 표현을 더하는 연결도 있지만, 우선 “입력의 숫자 표현을 갱신하는 단계”로 이해하면 충분해요.
여기서 가중치와 내부 상태를 구분해야 합니다. 가중치는 학습으로 정해진 계산 규칙이고, 내부 상태는 지금 입력을 그 규칙으로 처리한 결과예요. 파라미터 수는 이런 학습 가능한 값이 얼마나 많은지를 나타냅니다. 규칙이 같아도 입력 상태가 달라지면 계산 결과는 달라져요. (Huginn 구조 설명, Looped Transformer §2)
다음 층으로 갈까, 같은 블록을 다시 쓸까?
일반적인 Transformer는 서로 다른 층을 차례로 지나가요. 각 층은 대체로 자기 가중치를 가지고, 앞선 층이 갱신한 상태를 받아 다시 처리합니다.
Looped Transformer는 일부 계산 블록을 재사용해요. 앞선 계산으로 갱신된 상태를 같은 블록에 넣어 다음 반복을 수행합니다. 같은 질문을 여러 번 보내는 외부 재시도가 아니라, 모델 내부의 숫자 표현에서 이어지는 계산이에요.
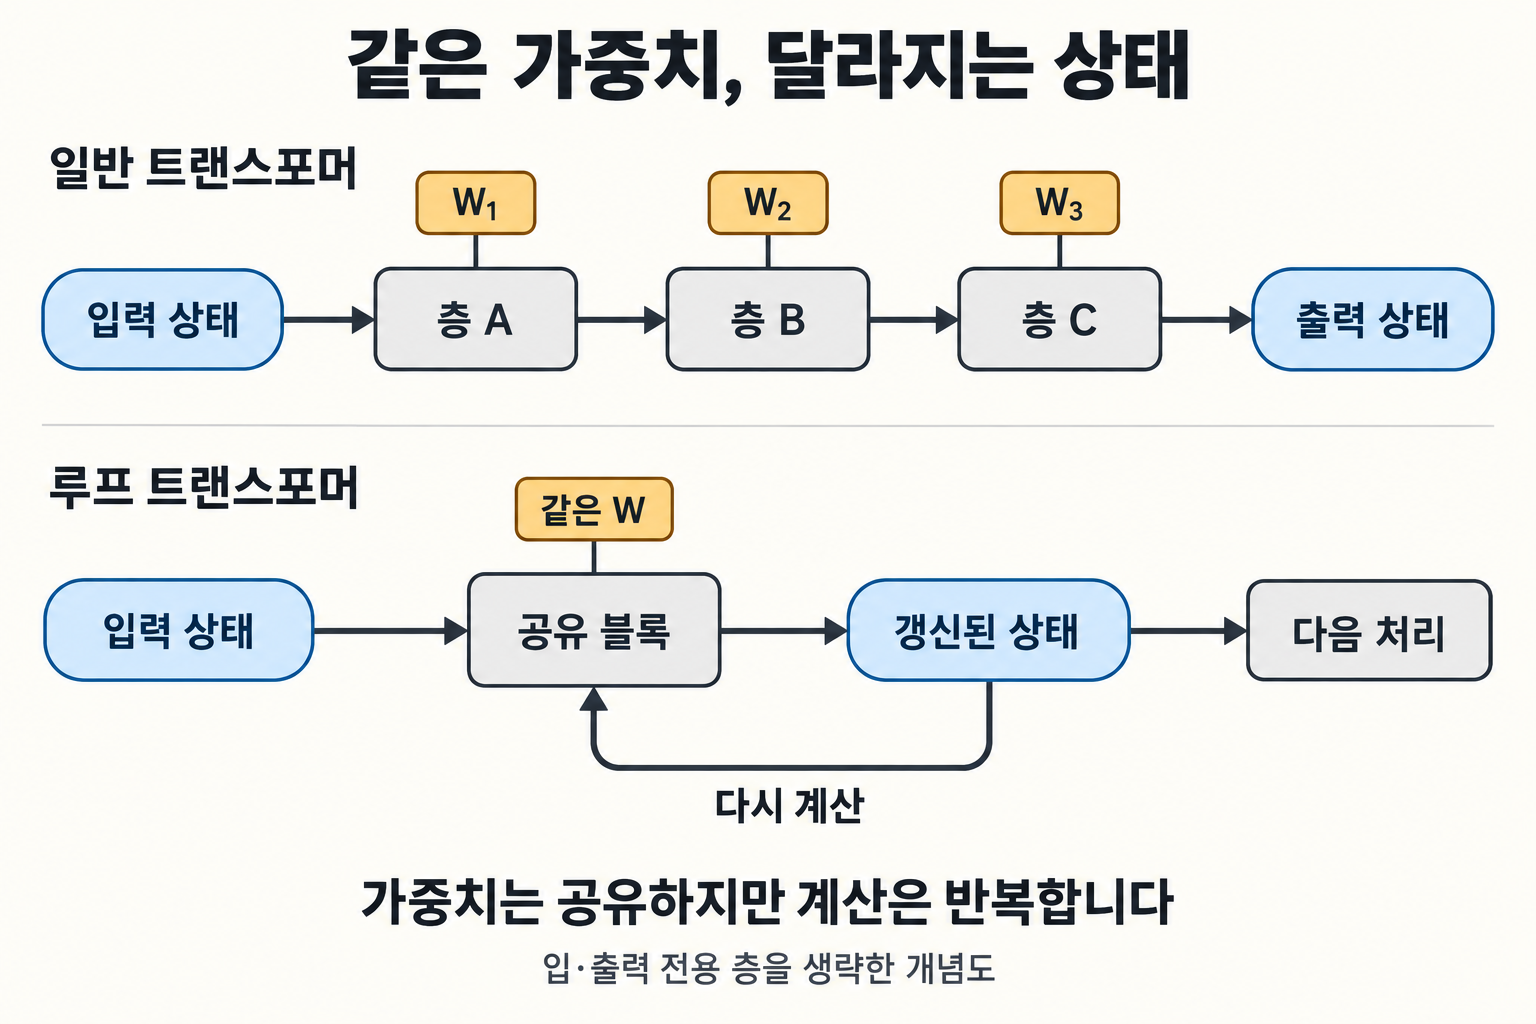
그림 1. 일반 구조는 서로 다른 층을 지나가고, 루프 구조는 공유 블록의 가중치를 재사용해요. 반복되는 것은 계산이며 가중치를 여러 벌 복제하는 것은 아닙니다. 설명을 위한 자체 제작 개념도로, 입·출력 전용 층과 실제 모델의 세부 연결은 생략했습니다. 근거: Huginn, Shared Memory §2.
이 구조가 아끼는 것은 우선 가중치 저장 공간이에요. 같은 가중치를 반복 횟수만큼 새로 저장하지 않아도 되거든요. 하지만 Attention과 표현 변환은 반복마다 실행합니다. 가중치 공유는 연산 공유가 아닙니다.
Huginn 논문은 3.5B 모델의 반복 계산을 늘려 고정 깊이 50B Transformer에 해당하는 계산 예산까지 일부 평가의 성능 향상을 관찰했다고 설명해요. 이는 50B 모델과 같은 성능을 달성했다는 의미가 아니라, 저장 크기와 계산 깊이를 분리한 사례입니다. (Huginn §5)
반복한다고 원하는 추론이 저절로 학습되는 것도 아니에요. 후속 해석 연구는 Huginn의 산술 과제에서 뚜렷한 잠재 풀이 순서를 확인하지 못했지만, 관찰 도구의 한계 때문에 그 부재를 확정하지도 않았습니다. 구조의 가능성과 실제 품질은 따로 확인해야 해요. (Huginn 해석 연구)
가중치는 한 벌인데, 문맥 메모리는 여러 벌일 수 있어요
모델이 다음 토큰을 만들 때 과거 토큰의 정보를 매번 처음부터 계산하면 비효율적이에요. 그래서 Attention에 필요한 과거 토큰의 Key와 Value를 보관합니다. 이것이 KV 캐시예요. 단순화하면 Key는 참고할 정보를 찾는 데, Value는 가져올 정보에 해당합니다.
KV 캐시는 가중치나 장기 기억이 아니라 현재 문맥을 처리하며 만든 정보예요. 문맥이 길어질수록 보관할 내용도 늘어납니다. 루프 구조에서는 같은 토큰도 반복 단계마다 표현이 달라질 수 있어서, 많은 기본 구현은 반복별로 별도의 캐시를 유지해요.
가중치를 적게 저장하더라도 문맥 메모리는 커질 수 있는 거죠. 최근 연구는 이 캐시를 어떻게 공유할지 다르게 설계합니다.
MELT는 층별 공유 캐시를 갱신해요. gate라는 조절 장치로 새 정보와 기존 캐시를 섞어 반영합니다. 반면 LPT는 첫 반복의 전체 문맥 캐시를 이후에도 읽으면서, 이후 반복마다 작은 로컬 캐시를 함께 유지해요. (MELT, Shared Memory §3)
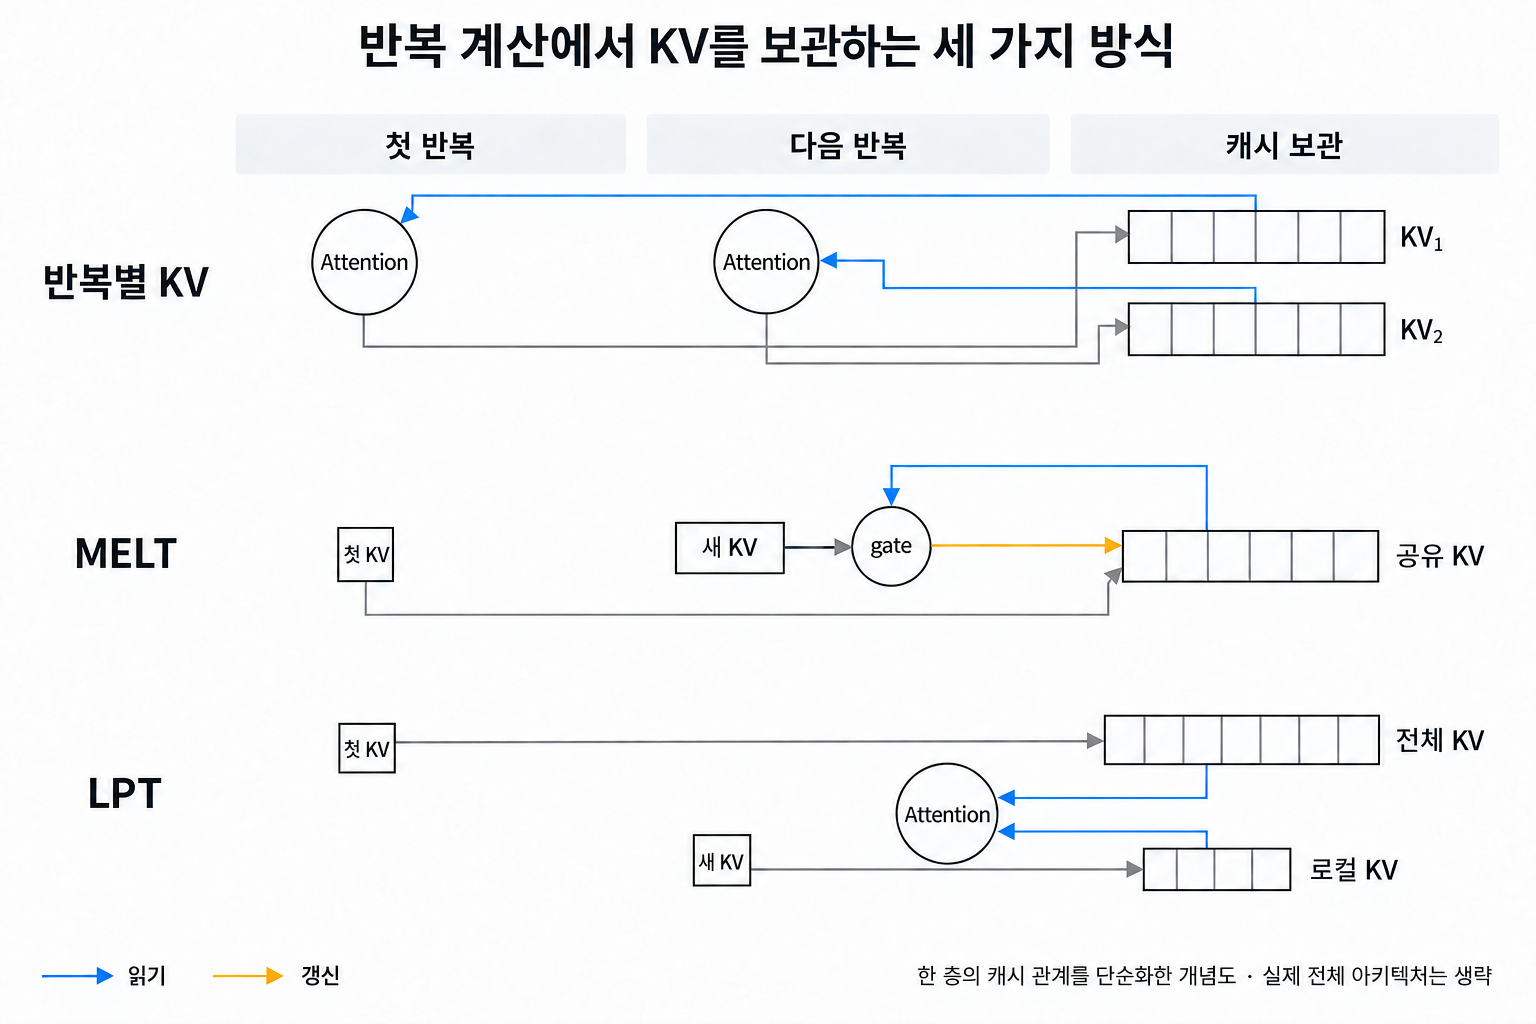
그림 2. 가중치 공유와 캐시 공유는 별도의 설계예요. 한 층을 기준으로 캐시의 보관·갱신·읽기 관계만 그린 자체 제작 개념도이며, 논문 전체 아키텍처를 그대로 옮긴 그림은 아닙니다. H-LPT는 순수 LPT와 달리 Attention 층과 다른 종류의 상태 갱신 층을 섞은 hybrid입니다. 근거: MELT, LPT / H-LPT.
그림의 첫 KV는 첫 반복에서 계산한 Key와 Value, 새 KV는 다음 반복에서 새로 계산한 값을 뜻해요. 오른쪽의 긴 칸들이 보관되는 캐시입니다. MELT는 공유 캐시를 갱신하고, LPT는 첫 반복의 전체 캐시와 현재 반복의 로컬 캐시를 함께 읽어요. 작은 라벨은 그림을 확대해 확인할 수 있습니다.
이런 설계로 반복 깊이에 따른 캐시 증가를 줄일 수 있어요. 다만 문맥 길이까지 무관해지는 것은 아닙니다. 줄어든 KV 캐시는 전체 GPU 메모리의 일부이고, 청구 비용도 별도의 측정 대상이에요. 특히 순수 LPT의 일반 looped 모델 대비 절감과, H-LPT의 표준 모델 대비 절감은 서로 다른 비교입니다.
더 많이 처리하지만, 한 사람은 더 기다립니다
LPT의 캐시 절감이 실제로 어떤 차이를 만드는지 보죠. 논문 부록은 1B 규모의 모델이 같은 블록을 5회 반복하는 조건에서 일반 looped 모델 LT와 LPT를 비교합니다.
- GPU 전체 처리량: LT는 초당 303토큰, LPT는 초당 578토큰.
- 요청 하나의 계산 지연: batch=1에서 다음 토큰을 만드는 한 단계가 LT는 37.9ms, LPT는 42.3ms.
전체 처리량은 높아졌지만 개별 지연은 길어졌어요. 두 수치가 다른 질문에 답하기 때문입니다. 처리량은 일정 시간에 처리하는 전체 양이고, 지연은 특정 요청이나 단계에 걸리는 시간이에요.
여러 요청을 묶어 처리하는 단위를 batch라고 합니다. 위 처리량은 각 모델이 메모리에 올릴 수 있는 최대 batch에서 측정했어요. LT는 21개, LPT는 101개였습니다. 반면 지연은 두 모델 모두 batch=1에서 측정했습니다.
캐시가 작아져 GPU에 더 많은 요청을 함께 올릴 수 있었던 거예요. 그렇다고 요청 하나가 거치는 반복 계산이 사라지지는 않습니다. 많은 요청을 처리해야 하는 서비스에는 이득일 수 있지만, 응답을 기다리는 한 사람에게는 더 느린 선택일 수 있어요.
이 실험은 H100 80GB, bf16 정밀도, 문맥 4,096토큰의 동일 연구 구현에서 진행했습니다. 속도 측정에는 random weight를 사용했고, 품질 평가는 별도로 학습한 모델에서 했어요. 최적화된 서비스 엔진의 결과도, 사용자의 전체 응답 시간도 아닙니다. (Appendix F, Table 8)
연산량에 대한 경계도 남습니다. 저자는 순수 LPT가 메모리를 아끼지만 계산량 관점에서 최적인 것은 아니라고 명시해요. 비교는 저장 파라미터 수를 맞춘 것이며, 연산량을 맞춘 표준 모델을 학습해 비교한 결과는 아닙니다. 캐시 절감만으로 동일 품질에서의 경제성까지 확인됐다고 볼 수는 없어요. (Limitations)
비용을 줄이려면 무엇을 덜 해야 할까요?
반복이 계산을 추가하더라도 더 느린 작업을 대신하면 시간이 줄어들 수 있어요. LOTUS는 긴 풀이를 텍스트로 한 토큰씩 만드는 대신 잠재 상태의 여러 위치를 병렬로 처리합니다. 정답 풀이를 이용한 감독 학습도 함께 들어가요. 단순히 반복 구조만 바꾼 결과가 아닙니다.
여기서 보고한 추론 단계의 가속과 입력 처리·답 생성까지 합한 전체 가속은 구분해야 합니다. 수학 과제의 결과를 코딩이나 한국어 응답으로 그대로 옮길 수도 없어요. (LOTUS Table 2–3 및 한계)
FlashLoop는 기존 looped 모델을 재학습하지 않고 반복 사이의 중복을 줄입니다. 거의 바뀌지 않는 상태를 재사용하고 필요한 Attention 계산을 선택하며, KV의 차이를 낮은 정밀도로 저장해요. 반복의 매 단계에서 모든 것을 다시 계산하고 보관하지 않도록 만드는 접근입니다. 다만 일부 평가 점수 하락도 보고돼, 품질 무손실을 보장하는 방식으로 읽어서는 안 됩니다. (FlashLoop §3–5, Table 1)
앞의 캐시 설계와 이 두 사례는 같은 종류의 개선이 아니에요. 캐시를 공유할지, 학습을 통해 긴 순차 생성을 대신할지, 추론 구현에서 중복을 줄일지에 따라 아끼는 비용이 달라집니다.
모델 크기보다, 같은 품질로 끝내는 비용
작은 모델을 여러 번 돌리면 저렴해질 수 있어요. 다만 작은 저장 크기만으로 판단할 수는 없습니다. 반복 연산과 캐시, 동시 처리량과 개별 지연을 함께 봐야 해요.
제 판단 기준은 도입의 질문으로 돌아옵니다. 같은 과제의 정확도와 장문 처리 품질을 만족하는지 먼저 보고, 그 조건에서 요청을 끝내는 데 필요한 GPU 사용 시간과 대기 시간을 비교하는 거예요. 실패해서 다시 시도하거나 더 큰 모델로 넘기는 비용도 포함해야 합니다.
여기서 대기 시간은 평균 하나로 끝내지 않는 편이 좋겠어요. 첫 토큰까지 얼마나 기다리는지, 이후 토큰은 얼마나 빠르게 나오는지, 동시 요청이 늘어도 느린 요청의 꼬리가 감당할 만한지 봐야 합니다. 이는 논문들이 공통으로 실측한 결론이 아니라, 결과를 서비스 판단으로 옮길 때의 제 해석입니다.
Looped Transformer의 흥미로운 점은 작은 모델로 큰 모델을 공짜로 대체한다는 약속보다, 저장 크기와 계산 예산을 따로 설계할 수 있다는 데 있다고 생각합니다. 그 선택이 정말 저렴한지는 모델 크기가 아니라, 같은 품질로 요청을 끝내는 비용에서 확인해야 할 것 같습니다.
참고문헌
- Scaling by Thinking in Continuous Space — Huginn, v1.
- Latent Chain-of-Thought? Decoding the Depth-Recurrent Transformer — Huginn 해석 연구, v2.
- Memory-Efficient Looped Transformer: Decoupling Compute from Memory in Looped Language Models — MELT, v2.
- The Surprising Effectiveness of Shared Memory in Looped Transformers — LPT / H-LPT, v1.
- Bridging the Gap Between Latent and Explicit Reasoning with Looped Transformers — LOTUS, v1.
- FlashLoop: Fast and Memory-Efficient Looped Transformers via Lazy Updates — FlashLoop, v2.
- Huginn 공개 코드 저장소 — README와 공개 추론 구현.