Agent Harness를 기능 목록으로 설계하면 놓치는 것
read, grep, bash를 붙이면 chatbot은 agent처럼 보이기 시작합니다. 파일을 읽고, 필요한 부분을 찾고, 명령도 실행할 수 있으니까요.
그런데 실제 프로젝트에 넣는 순간부터 진짜 문제가 시작됩니다. agent는 엉뚱한 도구를 고르고, 위험한 명령을 너무 쉽게 실행하고, 긴 출력으로 자기 맥락을 채웁니다. 탐색·수정·판단을 한 흐름에 몰아넣으면 권한도 책임도 뒤섞입니다. 중간에 멈춘 뒤에는 어디까지 했는지 잃어버리기도 합니다.
이때 필요한 것은 기능을 더 많이 붙이는 일이 아니라, 어느 실패가 먼저 나타나고 그 실패에 어떤 경계를 다음으로 더할지 정하는 일입니다.
제가 보기에는 Agent Harness는 도구·권한·상태·검증의 목록이 아닙니다. 에이전트가 실제 작업에서 차례로 부딪히는 실패를 보고, 다음 설계로 그 실패를 막아 가는 구조에 가깝습니다.
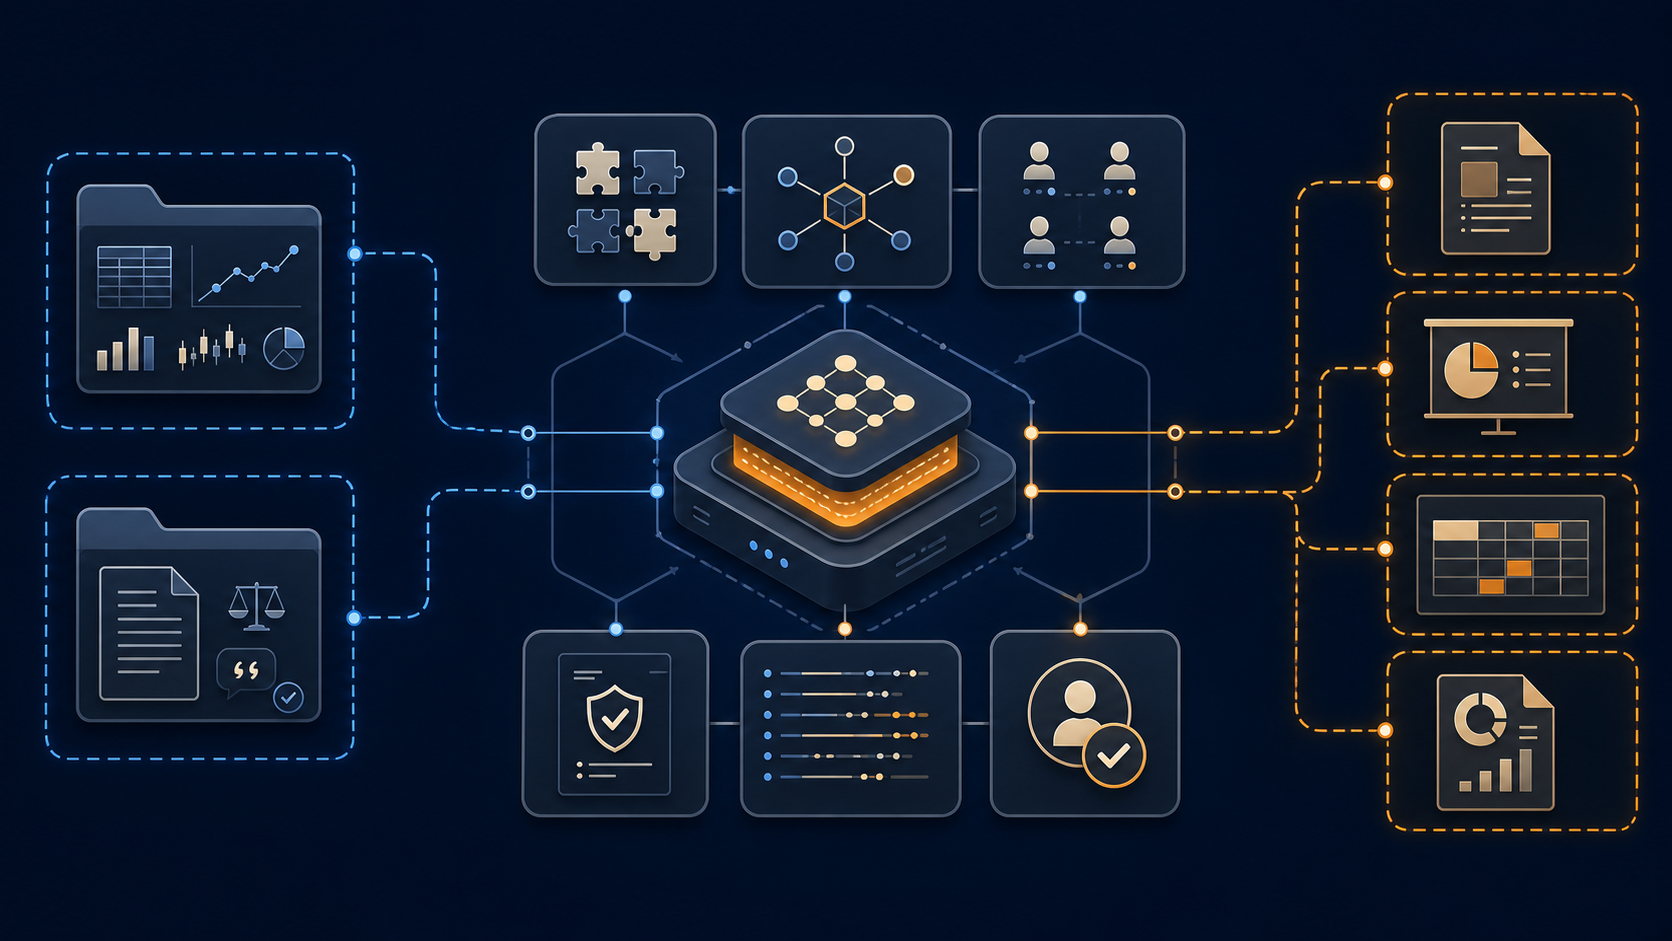
Agent Harness는 도구·권한·실행 환경·기록을 연결해, 에이전트가 실제 작업을 이어 갈 수 있게 만드는 실행 구조다. 개념도이며 특정 제품 구조를 재현한 그림은 아니다.
도구 세 개를 붙였는데도, 진짜 문제는 이제부터다
처음에는 관찰 능력이 부족합니다. agent가 파일을 보지 못하면, 그럴듯한 설명을 할 수는 있어도 코드베이스에 대해 말할 근거가 없습니다. 그래서 read가 필요하고, 파일이 늘어나면 grep이 필요해집니다.
하지만 명령 실행 도구까지 붙이면 문제의 성격이 바뀝니다. 이제 agent는 할 수 없는 존재가 아니라, 너무 많은 일을 할 수 있는 존재가 됩니다. 무심코 실행한 명령이 파일을 바꾸거나 환경에 영향을 줄 수 있고, 편한 도구 하나로 모든 문제를 풀려 할 수도 있습니다.
작은 agent가 커질 때의 어려움은 모델이 갑자기 덜 똑똑해져서 생기지 않습니다. 능력이 늘어난 뒤에 생기는 실패를 아직 설계에 반영하지 않았기 때문에 생깁니다.
실패는 다음 기능을 부른다
하네스를 구성하는 요소를 한꺼번에 나열하면 복잡한 체크리스트처럼 보입니다. 하지만 각 요소를 앞 단계의 실패에 대한 응답으로 보면 순서가 보입니다.
| 먼저 깨지는 것 | 다음에 필요한 설계 |
|---|---|
| 파일을 볼 수 없음 | read, grep 같은 관찰 도구 |
| 명령을 무심코 실행함 | tool contract, execute-level gate, approval |
| 프로젝트마다 규칙이 다름 | system prompt, project context, AGENTS.md |
| 로컬·인메모리·클라우드 실행이 뒤섞임 | sandbox abstraction |
| 긴 작업에서 tool output이 맥락을 점유함 | bounded output, pruning, cache control |
| 한 agent가 탐색·수정·판단을 모두 함 | read-only explorer와 executor의 역할·도구·맥락 분리 |
| 중단 뒤 어디까지 했는지 사라짐 | lifecycle, snapshot/restore, durable state |
| 애매한 판단을 임의 실행함 | human-in-the-loop와 ambiguity protocol |
| 기능과 접점이 늘어남 | skills의 progressive disclosure, event bus, custom tool extension |
표의 왼쪽은 추상적인 위험 목록이 아닙니다. 실제로 agent를 조금씩 쓸모 있게 만들 때 나타나는 장면들입니다. 관찰을 위해 도구를 열어 주면 선택과 실행의 경계가 필요해집니다. 작업이 길어지면 맥락을 관리해야 합니다. 역할을 나누면 각 역할이 볼 수 있는 정보와 할 수 있는 행동도 다시 정의해야 합니다.
그래서 tool description도 단순한 사용 설명서가 아닙니다. 어떤 도구를 써야 하는지, 쓰지 말아야 하는지 모델에게 알려 주는 선택의 경계입니다. 다만 설명만으로 위험한 실행을 막을 수는 없습니다. 실행 권한, 허용 범위, 승인 절차가 따로 있어야 합니다.
마찬가지로 context management는 대화가 길어졌을 때 요약 한 번 하는 문제가 아닙니다. 처음부터 출력 크기를 제한하고, 오래된 결과를 정리하고, 반복되는 안정적 맥락은 캐시하기 좋게 분리하는 식으로 다뤄야 합니다. 맥락은 저장 공간이 아니라 예산에 가깝기 때문입니다.
순서를 바꾸면 생기는 일
이 관점은 “처음부터 완성형 하네스를 만들어야 한다”는 뜻이 아닙니다. 오히려 반대에 가깝습니다.
작은 문서 수정 agent에 durable workflow나 복잡한 sandbox lifecycle이 꼭 필요하지는 않습니다. 읽을 수 있는 경로를 제한하고, 수정 전 확인을 받고, 결과를 다시 읽어 보는 정도면 충분할 수 있어요.
반면 장시간 실행이 시작되고, 외부 상태를 바꾸고, 사람이 중간에 작업을 이어받아야 한다면 이야기가 달라집니다. 그때 lifecycle은 나중에 붙이면 좋은 기능이 아니라, 상태가 사라지는 것을 막기 위한 선행 조건이 됩니다. snapshot과 restore를 고민하지 않으면 중단은 곧 작업 손실이 됩니다.
subagent도 마찬가지입니다. agent를 여러 명 부르면 성능이 좋아진다는 식의 문제는 아닙니다. 탐색에는 읽기 전용 도구와 작은 맥락이 적합할 수 있고, 수정에는 더 좁게 정의한 쓰기 권한이 필요할 수 있습니다. 역할을 나누는 이유는 숫자를 늘리기 위해서가 아니라, 권한·비용·맥락·책임을 분리하기 위해서입니다.
결국 중요한 질문은 “우리 agent에 sandbox가 있는가”가 아닙니다. 지금 작업에서 어떤 부작용과 어떤 지속성이 생겼는가, 그리고 그 다음 병목은 무엇인가에 더 가깝습니다.
Vercel Academy가 보여주는 것은 구현 예제가 아니라 설계 순서다
Vercel Academy의 Build Your Own AI Coding Agent Harness 과정은 이 순서를 비교적 선명하게 보여줍니다. 공식 과정은 11개 모듈, 38개 lesson으로 구성됩니다.
Agent Loop에서 시작해 Tool Design, System Prompt, Sandbox Abstraction, Context Management, Subagent Delegation, Sandbox Lifecycle, Human-in-the-Loop, Planning and Verification, Surfaces, Extensibility로 이어집니다.
과정은 Vercel의 도구와 TypeScript 구현을 예시로 사용합니다. 따라서 그 구체적인 runtime이나 제품 선택을 모든 환경의 정답으로 읽을 수는 없습니다. 다만 앞 단계가 깨질 때 왜 다음 단계가 필요해지는지를 따라가는 방식은, 특정 구현을 넘어 참고할 만한 설계 순서로 읽힙니다.
예를 들어 bash를 붙인 뒤에 approval을 다루고, 프로젝트별 규칙이 필요해진 뒤에 system prompt와 project context를 다룹니다. 긴 작업의 출력이 쌓인 뒤에는 context management로 가고, 모호한 요청을 임의로 처리하는 문제가 드러난 뒤에는 human-in-the-loop를 다룹니다. 기능의 목록이 아니라 실패의 인과가 커리큘럼의 뼈대가 되는 셈입니다.
하네스는 체크리스트가 아니라 다음 경계를 고르는 과정이다
Agent Harness를 도입할 때 “권한, sandbox, memory, multi-agent, evaluation을 모두 갖추자”라고 시작하면, 무엇이 지금 필요한지 금방 흐려집니다.
더 나은 출발점은 작은 실패를 정확히 보는 일인 것 같습니다. agent가 파일을 보지 못하는가. 도구를 잘못 고르는가. 실행 범위가 불안한가. 작업이 길어질수록 앞선 관찰을 잊는가. 멈춘 뒤 다시 시작할 수 없는가. 사람에게 물어봐야 할 일을 추측하는가.
하네스는 모델을 감싸는 체크리스트가 아닙니다. 지금 agent가 어디서 실패하는지 보고, 그 실패가 다시 일어나지 않게 다음 경계를 더하는 설계 과정입니다.
완료 선언의 근거와 검토 역할을 어떻게 분리할지는 AI Agent가 “완료했다”고 말했을 때, 무엇을 믿어야 할까에서 별도로 다뤘습니다. workspace·권한·로그·checkpoint 같은 하네스의 일반 구성요소는 AI Agent가 일하려면 채팅창보다 먼저 필요한 것에서 더 넓게 정리했습니다. 이 글은 그 요소들이 왜 한꺼번에가 아니라 실패의 순서에 따라 등장하는지에 초점을 둡니다.
참고 자료
- Vercel Academy, Build Your Own AI Coding Agent Harness